
Benchmarks de IA: o que medem, onde conferir, e por que o número sozinho não decide nada
Score de benchmark não é propriedade de um modelo. É de um sistema, numa data. Como ler o número, onde conferir, e o caso de setembro em que o mesmo modelo fez 62% e 99% no mesmo teste, no mesmo dia.
Revisado em 07 de setembro de 2026, mesma data da publicação. Guia de ferramenta envelhece: se a tela da ferramenta mudou desde então, o caminho aqui pode ter mudado também.
Guia completo
Deixa seu nome e e-mail pra continuar lendo
Você destrava este guia, os outros guias e todos os materiais.
Você preenche uma vez só. Depois disso tudo o que é fechado abre direto neste navegador, e o mesmo e-mail te coloca na newsletter.
O que você vai aprender
Como ler um número de benchmark (teste padronizado que compara modelos de IA) sem ser enganado por ele. O que cada família de teste mede de verdade, onde estão as fontes que valem, e por que um score alto pode não dizer nada sobre a sua operação.
Não precisa de conhecimento técnico. Todo termo é traduzido na primeira vez que aparece.
1. O que é um benchmark, e por que a comparação simples engana
Comece pela analogia
Pense num concurso público. A prova é a mesma pra todo mundo, o gabarito é o mesmo, e no fim sai uma lista com notas. Benchmark de IA é isso: uma prova padronizada que vários modelos fazem, pra dar uma nota que se possa comparar.
Só que existe uma diferença que muda tudo. No concurso, o candidato entra sozinho na sala, com caneta e papel, e ninguém pode ajudar. Com IA, quem aplica a prova decide se o modelo entra sozinho ou acompanhado. Pode dar acesso à internet, pode deixar ele tentar cinco vezes e contar a melhor, pode dar duas horas ou dez minutos, pode deixar ele rodar código pra conferir a própria resposta.
O mesmo candidato, na mesma prova, tira notas diferentes conforme essas escolhas. E a nota que circula por aí quase nunca vem acompanhada de quais foram.
As quatro peças de um benchmark
Todo teste é a combinação de quatro coisas. Vale conhecer as quatro, porque só a primeira aparece nas manchetes:
- Um conjunto fixo de tarefas. Perguntas de prova, bugs de verdade tirados de projetos reais, planilhas pra preencher, comandos pra rodar num terminal.
- Um critério de acerto que a máquina consiga julgar sozinha. Gabarito de múltipla escolha, teste de software que passa ou não passa, um verificador matemático, outro modelo de IA fazendo papel de juiz, ou voto de gente de verdade.
- Um harness (leia “rârnes”): é o código que fica entre a prova e o modelo. Ele apresenta a tarefa, decide se o modelo ganha ferramentas na mão, controla quantas tentativas ele tem, quanto tempo, e em que formato a resposta precisa sair. Em português já se traduziu como “andaime”, mas o termo que você vai encontrar em toda fonte séria é harness, e é ele que eu uso no resto deste guia.
- Uma configuração de execução. Quanto esforço de raciocínio o modelo pode gastar, quantas tentativas contam, e quanto dinheiro de processamento ele pode queimar em cada tarefa.
Quase todo mundo cita só o item 1 e o resultado. Os itens 3 e 4 são os que mais mexem no número, e são justamente os que desaparecem do print.
Quem cria e quem aplica esses testes
Não existe uma autoridade central. Isso não é detalhe burocrático: é a razão de o mesmo teste aparecer com números diferentes em lugares diferentes. Quatro tipos de gente cria e aplica benchmark, com interesses distintos:
| Quem | Exemplos | O interesse |
|---|---|---|
| Universidades e laboratórios de pesquisa | Stanford, Princeton, Berkeley, ETH | Publicar paper. Costuma ser o mais transparente sobre método, e o mais lento pra atualizar |
| Os próprios fabricantes de IA | OpenAI, Anthropic, Google | Mostrar que o modelo novo é melhor. Não é desonestidade automática: eles têm os melhores recursos pra construir teste difícil. Mas quem escolhe qual resultado publicar é quem está vendendo |
| Organizações independentes | Epoch AI, METR, ARC Prize, Artificial Analysis, Scale AI | Existem justamente pra rodar todos os modelos com o mesmo método. É de onde vem o número que presta |
| Sites que só juntam resultado alheio | Vários, que este guia chama de agregadores | Tráfego. Copiam número de todo lado, misturam configurações diferentes, e frequentemente não dizem de onde veio |
Onde os resultados moram, de verdade
Este é o ponto mais prático de toda a seção. Todo benchmark sério tem um lugar oficial onde o resultado é registrado, chamado de quadro ou leaderboard, e é ele que vale. A seção 5 lista os endereços um por um.
O problema é que a maioria das pessoas nunca chega lá. O número chega até você por um caminho bem mais curto: post de rede social → notícia de portal de tecnologia → site agregador → quadro oficial. A cada salto pra trás nessa cadeia, alguma informação foi jogada fora, e o que se joga fora primeiro é justamente a configuração: qual versão do teste, qual harness, quantas tentativas, quem rodou.
Para você ter ideia do tamanho do estrago, eu fiz essa medição em 7 de setembro de 2026, abrindo as páginas uma por uma: para o mesmo teste de programação, o quadro oficial registrava 79,2% e quatro sites agregadores mostravam 95%, 96%, 97% e 97%, apontando três líderes diferentes. Todos os números eram reais. Vinham de configurações diferentes, e nenhuma das páginas dizia qual.
O erro que este guia existe pra desfazer
A comparação simples soa assim: “o modelo A faz 90% e o B faz 85%, então o A é melhor”.
Ela quebra em quatro lugares ao mesmo tempo:
- Pode ser o mesmo teste em versões diferentes. Um teste de programação muito citado existe em cinco variantes com dificuldades radicalmente distintas. Comparar nota de duas variantes é comparar prova de nível médio com prova de mestrado.
- Pode ser o mesmo modelo com harness diferente. E este é o caso mais violento: na seção 3 eu mostro um resultado publicado em setembro de 2026 em que o mesmo modelo, no mesmo teste, no mesmo dia, aparece com 62,71% e 99,95%. A única coisa que mudou foi o código entre a prova e o modelo.
- Pode ser diferença dentro da margem de erro. No maior teste de preferência humana que existe, os dez primeiros colocados cabem hoje numa faixa tão estreita que a ordem entre eles é quase sorteio.
- E pode ser um teste que já não mede nada. Quando todos os modelos passam de 90%, o teste parou de diferenciar. Isso tem nome, saturação, e acontece com todo teste fixo depois de um tempo.
A regra que resolve a maioria das discussões: um score de benchmark não é uma propriedade do modelo. É a propriedade de um sistema, ou seja, modelo mais harness mais configuração, rodando num conjunto de tarefas, numa data. Quando alguém diz “o modelo X faz 90% no teste Y”, a frase está incompleta em quatro dimensões.
Como o resto do guia está organizado
Daqui pra frente é assim, e você pode pular direto pro que te interessa:
| Seção | O que tem lá |
|---|---|
| 2 | As cinco perguntas pra fazer diante de qualquer número. É o guia dentro do guia |
| 3 | Três gráficos de lançamento reais, destrinchados. É onde o caso dos 62% contra 99,95% aparece inteiro |
| 4 | O catálogo: oito famílias de teste, o que cada uma mede, e quais estão saturadas. Serve pra consulta, não pra leitura corrida |
| 5 | Os endereços oficiais, e por que agregador não serve como fonte |
| 6 | Os cinco motivos documentados pra um score alto não significar nada de útil |
| 7 | O que fazer em vez disso: como montar sua própria avaliação, com os seus casos |
| 8 | O contra-argumento, porque benchmark também tem defesa, e ela é boa |
| 9 e 10 | Um checklist pra colar do lado do monitor, e o resumo em cinco linhas |
2. As cinco perguntas antes de aceitar qualquer número
Isto é o guia dentro do guia. Se você levar só esta seção, já saiu no lucro.
| Pergunta | Por que importa |
|---|---|
| Qual versão do benchmark? | O SWE-bench existe em pelo menos cinco variantes com dificuldades radicalmente diferentes. O Terminal-Bench já teve quatro gerações em quinze meses. “OSWorld” hoje se refere a mais de um teste vivo, com números que não se comparam |
| Qual harness? | Aqui está o caso mais forte que existe, e ele é de setembro de 2026: o mesmo modelo, no mesmo teste, no mesmo dia, fez 62,71% com o harness padrão e 99,95% com outro. Trinta e sete pontos de diferença sem trocar de modelo |
| Quem rodou? | Score divulgado pelo próprio fornecedor no dia do lançamento é comunicação de marketing até alguém reproduzir de forma independente. Quadros sérios marcam o que é auto-reportado |
| Qual recorte? | Conjunto público, conjunto privado e conjunto padronizado do mesmo benchmark dão números diferentes. Eu já vi três valores de “melhor SWE-bench Pro” circulando juntos, todos reais, todos de recortes distintos, e nenhuma das páginas dizendo qual |
| Qual a data, e qual a margem de erro? | No topo dos quadros, a diferença entre o primeiro e o segundo costuma caber dentro do erro estatístico. Na Arena, o top 10 inteiro cabe hoje em 15 pontos |
3. Três gráficos de lançamento, e o que eles não dizem
Em setembro de 2026 a OpenAI lançou o GPT-6 Astra e publicou os gráficos abaixo. Eu não os escolhi por serem ruins. Escolhi porque são bons: os eixos são honestos, e um deles mostra custo, o que é mais do que a maioria faz.
O problema não está em nenhum gráfico. Está no conjunto.
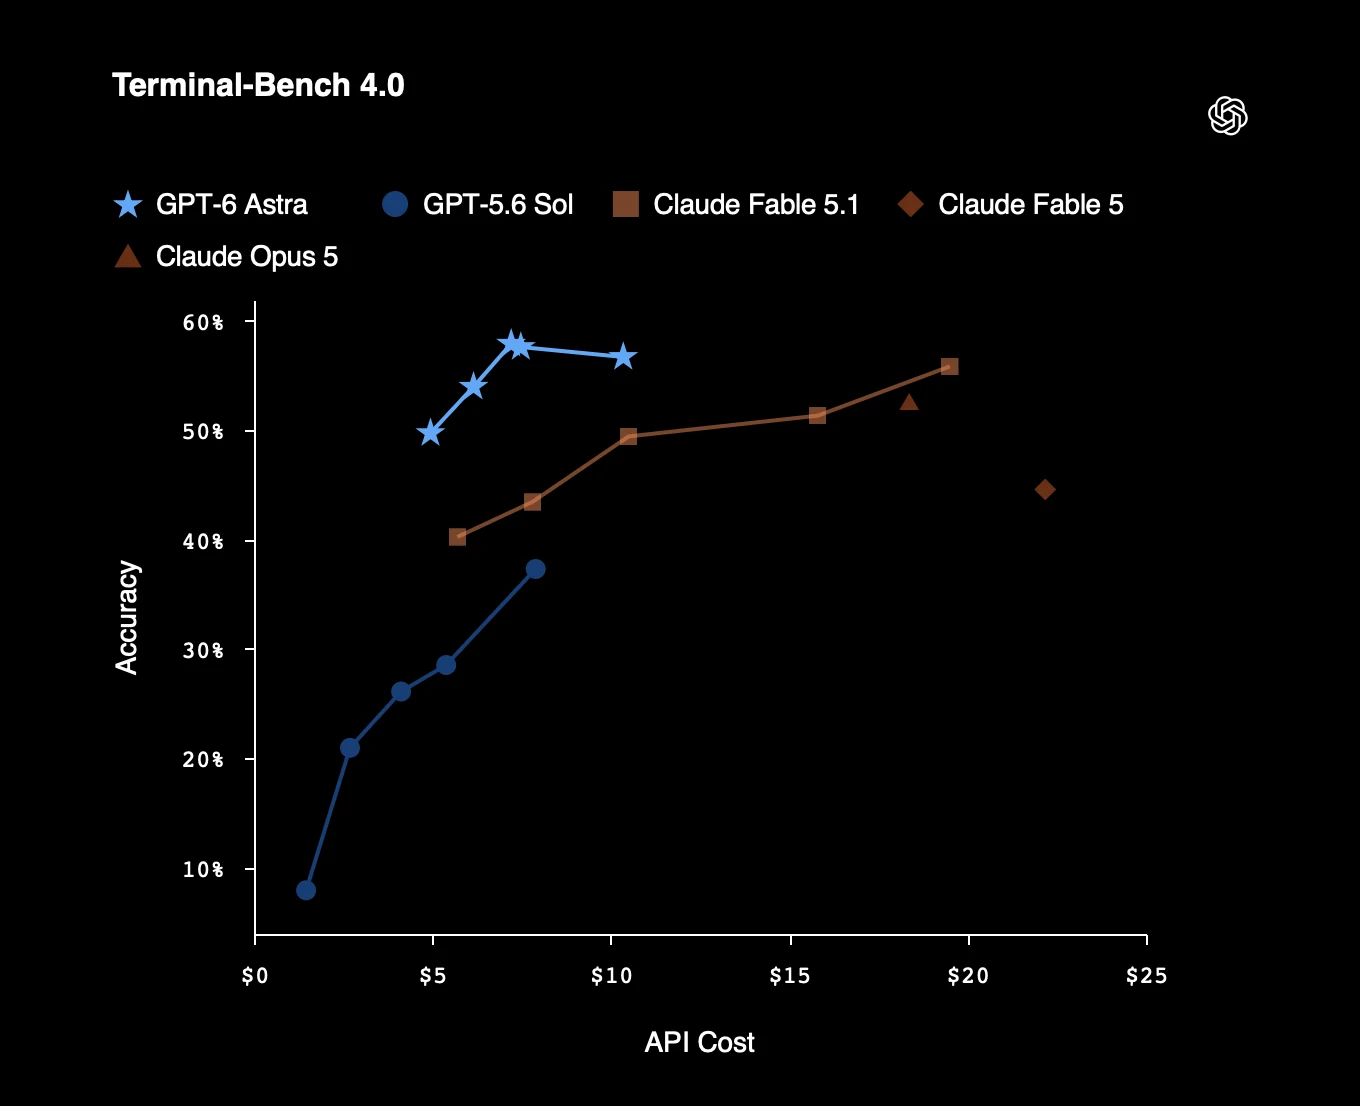
Terminal-Bench 4.0, gráfico publicado pela OpenAI no lançamento do GPT-6 Astra, setembro de 2026. Resultado auto-reportado pelo fornecedor.
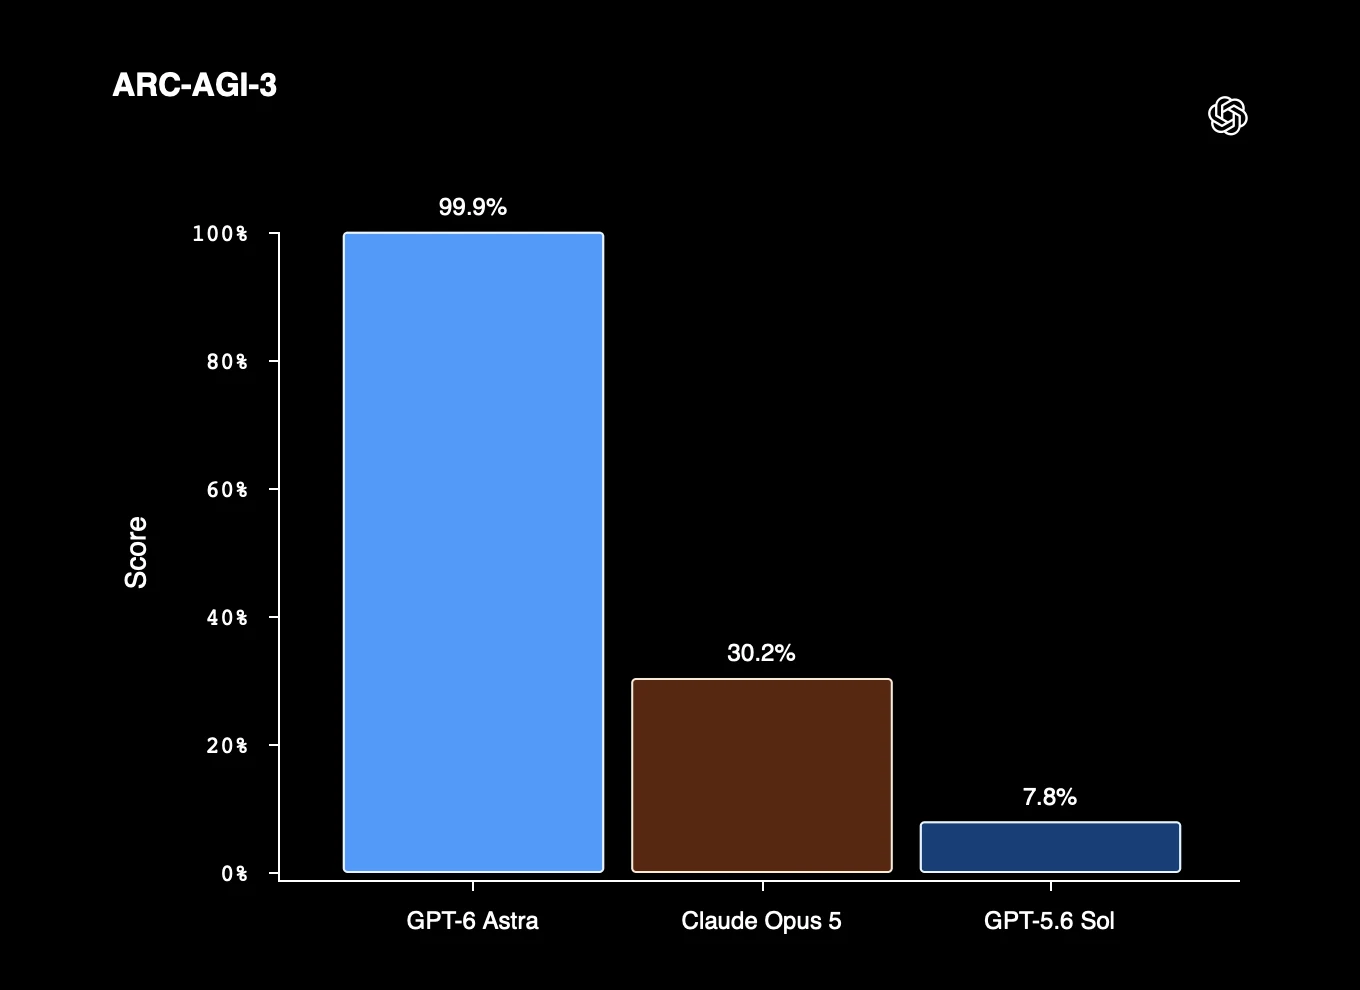
ARC-AGI-3, mesmo lançamento. Auto-reportado. Este é o gráfico que a seção inteira existe para destrinchar.
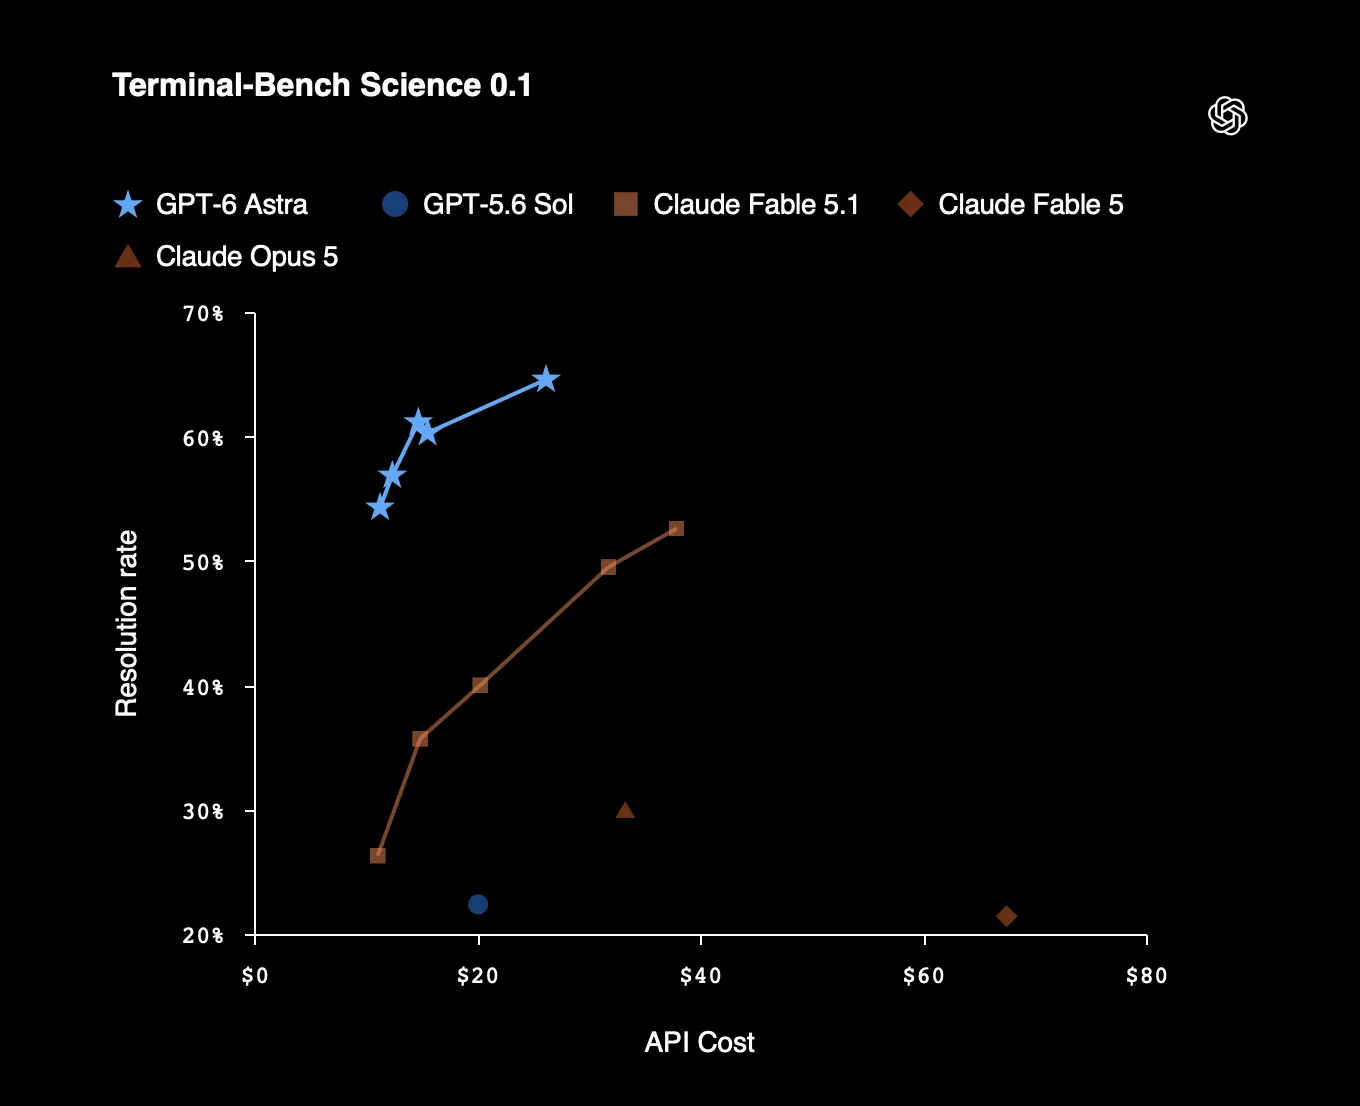
Terminal-Bench Science 0.1, mesmo lançamento. Auto-reportado.
O que o segundo gráfico realmente diz
Aquele 99,9% é verdadeiro, e está confirmado na página do ARC Prize, que é quem mantém o teste. Duas coisas que o gráfico não conta:
Primeira: o ARC-AGI-3 não pontua acerto. Ele pontua eficiência de ação em relação ao humano. Ou seja, aquele número não significa “resolveu 99,9% dos quebra-cabeças”. Significa “gastou quase o mesmo número de ações que uma pessoa gastaria”. É outra coisa, e quem lê a barra entende a primeira.
Segunda, e é a que importa: o mesmo modelo, no mesmo teste, no mesmo dia, tem dois resultados publicados.
| Andaime | Score do GPT-6 Astra no ARC-AGI-3 |
|---|---|
| Padrão do ARC Prize | 62,71% |
| “Provider Adapter” | 99,95% |
Trinta e sete pontos. Não mudou o modelo, não mudou o teste, não mudou a data. Mudou o código que liga um ao outro.
O gráfico mostra o 99,9% e não diz qual dos dois. Isso não é fraude: é o que acontece quando quem escolhe o recorte é quem está vendendo. E é por isso que a pergunta “qual harness?” da seção 2 não é preciosismo de engenheiro. Ela é a pergunta que mais move o número.
Para calibrar: no Terminal-Bench 2.1, trocar o harness moveu um modelo idêntico em 3,4 pontos, enquanto a distância entre postos vizinhos do quadro era menor que isso. O caso do ARC-AGI-3 é o extremo, mas o efeito é a regra, não a exceção.
4. Catálogo por família
Daqui pra frente é consulta. Você não precisa ler as tabelas de cabo a rabo: cada seção abre dizendo o que importa, e a tabela fica pra quando você precisar achar qual teste serve pra quê.
4.1 Conhecimento e raciocínio geral
Resumo honesto: esta família praticamente parou de diferenciar modelo. Os testes que definiram a conversa entre 2021 e 2024 hoje estão todos amontoados perto do teto, e sumiram até das tabelas de lançamento dos laboratórios.
| Benchmark | O que é | Estado |
|---|---|---|
| MMLU | Múltipla escolha de quatro alternativas, 57 áreas acadêmicas, 15.908 questões | Saturado e aposentado na prática. O GPT-3 fazia 43,9% em 2020; o primeiro acima de 90% foi o Gemini Ultra em dezembro de 2023, e mesmo esse usou 32 tentativas com voto. Não aparece mais na tabela de lançamento da Anthropic nem no relatório de segurança do GPT-6 Astra. E o paper de Gema et al. chamado “Are We Done with MMLU?” (2024) achou 6,49% das questões com erro de gabarito, chegando a 57% na parte de virologia |
| MMLU-Pro | Versão mais difícil, mais alternativas | Mesma trajetória |
| GPQA Diamond | 198 questões de nível pós-graduação, escritas por 61 especialistas com doutorado, feitas pra resistir a busca no Google | Ainda citado, e já comprimido: o topo hoje é 96,0%. Para comparar: não-especialista com internet liberada e mais de 30 minutos chega a 34%, e o especialista com doutorado a 65% |
| HLE (“Humanity’s Last Exam”) | 2.500 questões, do Center for AI Safety com a Scale AI. Só entraram perguntas que os modelos da época erravam | Não saturou, mas envelheceu rápido: saiu de 3 a 9% em janeiro de 2025 para 65,0% com ferramentas em setembro de 2026. Cuidado: o quadro oficial no site do HLE está parado, com 38,3% no topo. Quem cita o site oficial cita número velho |
| ARC-AGI-2 | Quebra-cabeças de grade colorida, de 1×1 a 30×30. Mede deduzir a regra a partir de exemplos, não recuperar conhecimento | O mais interessante conceitualmente. Humano médio faz 60%. E reporta custo por tarefa, não só acerto: humano resolve por cerca de US$ 17 por tarefa, e alguns sistemas de IA gastam centenas ou milhares de dólares no mesmo quebra-cabeça. Essa diferença de eficiência é o sinal real |
| ARC-AGI-3 | Versão interativa, com 135 ambientes. Pontua eficiência de ação, não acerto | Os dois quadros não são comparáveis, e a razão é estrutural: medem coisas diferentes. Ver a seção 3 |
Por que o ARC-AGI merece atenção separada: a maioria dos testes premia conhecimento memorizado. Esse premia adaptação a algo novo. É por isso que ele resistiu cinco anos e um aumento de 50.000 vezes no tamanho dos modelos antes de mostrar progresso de verdade.
4.2 Matemática
O que aprender aqui: matemática virou o lugar onde a medição está mais honesta, porque os testes novos são inéditos, privados ou formalmente verificáveis. E porque o placar deixou de ser porcentagem.
| Benchmark | O que é | Estado |
|---|---|---|
| GSM8K | 8.500 problemas de matemática escolar em forma de enunciado | Saturado. E é o caso melhor documentado de contaminação, que a seção 6 explica |
| MATH / MATH L5 | 12.500 problemas de competição, cinco níveis de dificuldade | O nível 5 ainda tem alguma utilidade |
| AIME | Não é a olimpíada americana, como se diz por aí: é a prova classificatória entre o AMC e a olimpíada de verdade. 15 questões, resposta inteira. Prova nova todo ano | Útil enquanto a edição é nova, e a renovação anual dá resistência natural à contaminação |
| FrontierMath (Epoch AI) | Problemas de matemática inéditos, em quatro faixas de dificuldade. Só a faixa 4 é nível de pesquisa | O mais difícil que existe. E tem um conflito de interesse que precisa ser dito: a OpenAI encomendou e financiou o benchmark, é dona dos 300 problemas centrais e tem acesso aos enunciados e às soluções. Só um conjunto de 50 problemas de retenção fica com enunciado sem solução. Chamar o teste inteiro de “privado” é impreciso |
| FrontierMath: Open Problems | Problemas de matemática não resolvidos. Nasceu em janeiro de 2026 com 14, e foi para 50 em julho | Aqui o placar não é porcentagem, é “quais caíram”. Hoje são seis resolvidos com IA. Um deles, uma matriz de Hadamard de ordem 668, caiu em agosto, creditado a três humanos trabalhando com um modelo |
| FrontierMath: Erdős | 68 problemas abertos de Erdős, formalizados em Lean, com prova conferida automaticamente. Nasceu em 1º de setembro de 2026 | Só um modelo pontuou, com 3%, ou seja, 2 de 68 |
| PutnamBench | Teoremas de competição, formalizados pra verificação automática | O exemplo mais bonito de saturação de 2026. Entre 26 de agosto e 5 de setembro, três sistemas diferentes resolveram todos os 672 problemas da parte em Lean. O quadro então passou a ranquear por custo, e a diferença entre os três que zeraram passa de duas ordens de grandeza: US$ 74 por problema contra US$ 0,17. Ele deixou de discriminar por acerto e passou a discriminar por preço |
4.3 Código
Se você contrata desenvolvimento ou automação, esta é a família que mais gente cita pra você. É também onde mais gente cita número que não existe.
| Benchmark | O que é | Estado |
|---|---|---|
| HumanEval / MBPP | Funções isoladas escritas a partir da descrição | Saturado, e o quadro oficial está parado desde 2024. Se alguém te vender um modelo citando HumanEval em 2026, o discurso está dois anos atrasado |
| LiveCodeBench | Problemas de competição coletados continuamente, com corte por data de publicação | Bom, porque a coleta contínua limita contaminação |
| SWE-bench Verified | 500 casos, filtrados por humanos, do SWE-bench completo (2.294 problemas em 12 repositórios Python) | Saturado e com problema de qualidade. Ver o quadro abaixo. E cuidado com a lista de repositórios que se repete por aí: o Django é 46% do benchmark, e o Flask é 1 caso em 500 |
| SWE-bench Pro (Scale AI) | 1.865 tarefas em 41 repositórios, resistente a contaminação por construção. O quadro público mede 731 casos de 11 repositórios | Ver o quadro abaixo |
| SWE-bench Live / Multilingual | Coleta contínua mensal, e extensão para além de Python. São dois projetos, de donos diferentes | Boas variantes contra contaminação |
| DeepSWE (Datacurve) | 113 tarefas escritas do zero, 5 linguagens, solução média de 668 linhas em 7 arquivos. Verificadores que testam comportamento, não o formato da correção | Metodologicamente convincente. Para calibrar a diferença: no Verified a solução média é de 10 linhas em 1 arquivo, e no Pro, 120 linhas em 5. Ressalva honesta: é novo, e mantido por um fornecedor comercial de dados de treino |
A história do SWE-bench, que vale mais que qualquer score
Esta sequência é o melhor estudo de caso que eu conheço sobre por que benchmark envelhece:
- A OpenAI auditou o Verified. Pegou os 138 problemas que o modelo o3 dela não resolvia de forma consistente em 64 tentativas, botou pelo menos seis engenheiros experientes em cada um, e achou que 59,4% deles tinham defeito no teste ou na descrição do problema. O benchmark estava errado exatamente onde deveria ser mais rigoroso.
- Em fevereiro de 2026 ela parou de reportar o Verified e recomendou publicamente que a indústria usasse o Pro.
- Em julho de 2026 ela retratou a recomendação. Auditou o Pro do mesmo jeito, estimou que cerca de 30% das tarefas dele estão quebradas, e escreveu que retirava o conselho anterior.
Hoje a OpenAI não recomenda nenhum dos dois. E tem uma ironia final, que eu confirmei nas duas pontas: no mesmo texto de julho ela cita 80,3% no conjunto público do Pro, quando o quadro oficial de quem mantém o benchmark tem topo de 61,50%. A fonte primária citando número auto-reportado em vez do quadro oficial, no texto em que critica a medição.
Os números de código que valem hoje, e os que não valem
| Afirmação que circula | O que a fonte primária diz |
|---|---|
| “SWE-bench Verified chegou perto de 100%” | O quadro oficial está em 79,2%, e parado desde fevereiro de 2026. Tudo acima disso vive em site agregador, auto-reportado |
| “Modelos caem de 80–95% no Verified para 59% no Pro” | Os 59% não são do harness padrão. Sob o harness padrão o melhor é 45,89%. E o modelo dos 59% não tem score de Verified publicado, então esse par nunca foi medido |
| “Um caso: 80,9% no Verified, 45,9% no Pro” | Os dois números são reais. Mas vêm de harness diferentes, então não é o mesmo sistema medido duas vezes |
| “Outro caso: 55% no Verified, 23,3% no Pro” | Os 23,3% são reais, de um modelo rodando com teto de 50 turnos e US$ 2. Mas o Verified dele é 74,9%, dito pelo próprio fornecedor no lançamento |
A queda do Verified para o Pro existe e é grande. O que não existe é o par de números específico que circula pra ilustrá-la.
4.4 Agentes, ferramentas e uso de computador
Esta é a categoria que mais se aproxima de trabalho de verdade. E é onde eu preciso te dar uma resposta menos animadora do que a que se lê por aí.
Diz-se que os testes de agente são “os que de fato diferenciam modelos em 2026”. É meia verdade. Eles diferenciam enquanto são novos. Cada geração satura em 6 a 12 meses, e é por isso que o Terminal-Bench passou por quatro gerações em quinze meses.
| Benchmark | O que mede | Estado hoje |
|---|---|---|
| Terminal-Bench | Tarefas num terminal Linux, com pontuação determinística. Cada tarefa tentada 5 vezes | A versão atual é a 4.0, de agosto de 2026, com 66 tarefas e limite de 8 horas por tarefa. A 2.1 está saturada, com topo entre 85% e 91%. Existe também o Terminal-Bench Science 0.1, linha nova, 70 tarefas em cinco domínios científicos, liderada por gente de Stanford |
| OSWorld | Controle de computador pela tela: o agente vê a imagem e age com mouse e teclado | As 369 tarefas são todas Ubuntu. Não existe uma única tarefa de macOS, ao contrário do que se repete. E a versão canônica hoje é a 2.0, com 108 tarefas de horizonte longo, cujo topo é 31,43%, não os 86% do quadro anterior. Os dois números medem coisas diferentes |
| τ-bench, τ²-bench, τ³-bench | Atendimento e fluxo de negócio com ferramentas e políticas. Muito perto do que agência de automação entrega | As três gerações existem, todas da Sierra. Atenção ao detalhe: o domínio de banco só existe no τ³, e o de varejo, que está nas três, é o que mais se esquece de citar |
| BFCL v4 | Chamada de função, com trilha de agente | Existe, da Berkeley. Mas o quadro parece parado há cerca de nove meses: o modelo mais novo é de novembro de 2025. Não cite score de 2026 daqui |
| GAIA | Assistente geral, três níveis | Saturado: o topo passou de 93% contra um humano de 92%. E existe GAIA 2 desde setembro de 2025, que abandonou os três níveis |
| GDPval (OpenAI) | Tarefas economicamente relevantes em 44 ocupações e 9 setores, com entregáveis reais: planilha, apresentação, memorando | Os dois números conferem. Mas o quadro da própria OpenAI foi desativado, e hoje aponta pro quadro de um terceiro |
| MLE-Bench, RE-Bench | Engenharia de aprendizado de máquina e pesquisa de IA | O MLE-Bench congelou submissões em abril de 2026. O RE-Bench não tem quadro público, e o achado dele é ótimo: com 2 horas de orçamento o agente rende 4 vezes o humano; com 32 horas, o humano rende o dobro do melhor agente |
| HAL (Princeton) | Meta-quadro: roda vários testes de agente com metodologia unificada | Pausado desde novembro de 2025, pelo próprio site. O que está vivo é o painel de confiabilidade deles |
Some a isso o problema do harness, e a conclusão fica assim: o que se diferencia não é modelo. É par de modelo com harness, e só na safra corrente do teste.
4.5 Preferência humana: a Arena
A Arena (antiga LMArena, e antes disso LMSYS Chatbot Arena) rebatizou em janeiro de 2026. São quase 8 milhões de votos cegos, um contra um, transformados numa escala parecida com o rating do xadrez.
O que você precisa saber pra ler direito:
- Existem três ajustes hoje, não dois. Sem controle, com Style Control e com Factuality, este último de julho de 2026, que ranqueia por preferência e acurácia factual junto. E o Style Control já é o padrão, ao contrário do que muito texto ainda diz.
- O Style Control remove quatro coisas: comprimento em tokens, número de títulos, de negritos e de listas. Não remove emoji, apesar de você ler isso em vários lugares.
- Mede preferência, não verdade. E isso tem número: no estudo de Wu e Aji chamado “Style Over Substance: Evaluation Biases for Large Language Models” (2023), anotadores humanos deram 1025 de rating para uma resposta longa com vários erros factuais graves, contra 970 para uma resposta curta e correta. Colocaram o texto errado acima do certo por ser mais longo.
- É cega a custo. Trinta pontos acima por dez vezes o preço pode ser a escolha errada pra produção.
- A distribuição de quem vota não é a sua. Se o seu caso é redigir cobrança para uma clínica em Santa Maria, o perfil de quem vota lá não te representa.
- O top 10 inteiro cabe em 15 pontos no quadro padrão, e 24,9 no bruto. Ou seja: a ordem do ranking, no topo, é quase irrelevante.
- Controvérsia documentada: o paper “The Leaderboard Illusion” (2025) aponta que laboratórios grandes testam muitas variantes privadas e submetem só a melhor, e identificou 27 variantes privadas de um único fornecedor antes de um lançamento. A Arena respondeu em detalhe, contesta parte dos números, e mantém registro público de mudanças de metodologia. A prática de testar variantes privadas é política escrita e vigente, não acusação.
- Um caso nomeado, e recente: o Yann LeCun disse ao Financial Times que os resultados do Llama 4 foram “fudged a little bit”, com versões diferentes do modelo em testes diferentes.
Uma coisa que eu não vou afirmar, porque não achei fonte primária: que fornecedores estejam treinando modelos em dados de preferência no estilo da Arena. Isso circula bastante e eu não confirmei.
4.6 Factualidade e alucinação
Categoria subvalorizada, e eu insisto nela por um motivo prático: para a maioria dos fluxos de operação, alucinação é o modo de falha que dói. Não raciocínio insuficiente.
| Benchmark | O que é |
|---|---|
| SimpleQA (OpenAI) | 4.326 perguntas factuais curtas |
| AA-Omniscience | 6.000 questões em 42 tópicos. Reporta acurácia e taxa de alucinação separadas, com um índice que combina as duas e não penaliza recusar responder |
| Vectara Hallucination Leaderboard | Relançado em novembro de 2025, com 7.700 artigos e documentos de até 32 mil tokens |
4.7 Autonomia e horizonte temporal
Na minha leitura, é a métrica mais informativa que existe hoje. E a mais honesta sobre os próprios limites.
O METR Time Horizons mede a duração de tarefa, medida pelo tempo que um especialista humano leva, na qual o agente acerta metade das vezes. A versão atual usa 228 tarefas, das quais 31 levam 8 horas ou mais.
Os achados que importam:
- O horizonte de 50% dobrava a cada 7 meses entre 2019 e 2025. Nos dados mais recentes a taxa acelerou para cerca de 2,9 meses desde 2024, e 4,3 meses desde 2023.
- O horizonte de 80% é de 4 a 6 vezes menor que o de 50%. Para trabalho que precisa de confiabilidade, o número relevante é o segundo, e ele quase nunca é o divulgado.
- A margem de erro no topo é enorme, e piorou. O melhor modelo tem intervalo de confiança cujo teto é 5 vezes a estimativa central.
- E o detalhe que eu acho o mais eloquente de todo este guia: o melhor modelo hoje tem horizonte de 50% em 17 horas e 25 minutos. A própria METR declara que “medições acima de 16 horas não são confiáveis com o nosso conjunto atual de tarefas”. Ou seja, o topo do quadro está fora da faixa em que o quadro se diz válido.
- A METR também publica a crítica contra si mesma: só 5 das 31 tarefas longas têm tempo humano medido, e um pesquisador deles escreveu que, se estiverem errando sistematicamente a duração das tarefas longas, podem estar julgando mal a aceleração.
Dois índices compostos, que tentam resumir capacidade num número:
- Epoch Capabilities Index (ECI): costura mais de 50 benchmarks numa escala única, com uma técnica emprestada de avaliação educacional. Ancorado em dois pontos fixos por definição. O paper é “A Rosetta Stone for AI Benchmarks”, e vale saber que foi financiado pelo Google DeepMind, com dois dos cinco autores de lá, embora o índice seja produto independente da Epoch.
- Artificial Analysis Intelligence Index: média ponderada de várias avaliações. E aqui está a melhor lição de todas: a versão v4.2 saiu em 4 de setembro de 2026, três dias antes de eu fechar este guia. Ela tirou o GPQA Diamond por saturação, acrescentou duas avaliações novas e dobrou a fatia de conjuntos privados, de cerca de 20% para 40%. Score coletado sob versões diferentes do índice não é comparável: a diferença pode vir da mudança da receita, não do modelo.
4.8 Português brasileiro
Ponto cego enorme da conversa internacional. Os índices que decidem reputação de modelo são compostos de testes de origem inglesa, sem exceção relevante.
| Benchmark | O que é |
|---|---|
| MTEB-BR | Teste de embeddings (representação numérica de texto, usada em busca e classificação) com 22 tarefas nativas de português brasileiro em sete categorias. Exclui traduções por construção. Avaliou 93 modelos, de 23 milhões a 27 bilhões de parâmetros: 73 abertos e 20 comerciais. Nota: “MTEB-PT” é o nome antigo do mesmo benchmark brasileiro, e não uma versão de Portugal |
| Napolab | Coleção de datasets de compreensão de linguagem em português, mantida por Ruan Chaves |
| PORTULAN ExtraGLUE | 14 datasets traduzidos por máquina para português, em variante europeia e brasileira. Útil, com a ressalva de que tradução automática introduz artefatos |
| MATH-PT | 1.729 questões de matemática de fontes originalmente em português, de olimpíadas e provas de Portugal e Brasil. Testou 13 modelos |
| LegalBench-BR | 3.105 processos de apelação do TJSC, coletados via API do CNJ, anotados em cinco áreas do direito |
O achado brasileiro, com as ressalvas que ele exige
O LegalBench-BR tem o resultado mais provocativo deste guia, e eu vou dar os números e o que eles não sustentam.
Um BERTimbau com LoRA (técnica de ajuste que treina uma fração mínima do modelo) atualizando 0,3% dos parâmetros, treinado em cerca de 30 minutos numa GPU grátis de nuvem, alcançou 87,6% de acurácia. Isso é 22 pontos percentuais acima do Claude 3.5 Haiku e 28 acima do GPT-4o mini na mesma tarefa. Na classe de direito administrativo, os dois modelos comerciais tiveram F1 de 0,00 e 0,08, contra 0,91 do modelo adaptado. E o paper documenta o motivo: os dois exibiram viés sistemático em direção à classe “cível”, absorvendo casos ambíguos em vez de discriminá-los.
Conferi todos esses números na fonte primária, e todos batem. Agora as três ressalvas, que estão na seção de limitações do próprio paper e sem as quais o argumento cai:
- O gabarito foi feito pelo Claude 3.5 Haiku. O paper usou o próprio Haiku pra classificar os processos, e depois corrigiu 196 registros por regra, predominantemente jogando casos administrativos para cível. Ou seja, aquele F1 de 0,08 é em parte definição, não descoberta.
- O conjunto de teste tem 105 exemplos, 21 por classe. O contraste entre 0,00 e 0,91 repousa em 21 casos.
- No conjunto original, sem balancear, o Haiku faz 94,5%. A vantagem de 22 pontos existe no conjunto balanceado, que é a escolha metodológica certa, mas precisa ser dita. Sem ela, o leitor entende que o modelo comercial erra um caso em três no mundo real, e não é isso que o paper mostra.
O que sobrevive, e ainda é muito: um modelo pequeno adaptado ao domínio, treinado em meia hora de graça, bateu dois modelos comerciais baratos numa tarefa jurídica brasileira, e eliminou um modo de falha que nenhum quadro internacional teria mostrado. A comparação não foi contra a fronteira, e o paper não esconde isso.
5. Onde conferir
Fontes primárias, que são as que valem
| Fonte | Endereço | Para quê |
|---|---|---|
| Epoch AI, Benchmarking Hub | epoch.ai/benchmarks |
Metodologia própria padronizada, dados brutos publicados, resultado interno separado do externo. A referência mais rigorosa |
| Epoch Capabilities Index | epoch.ai/eci |
Visão composta e tendência no tempo |
| METR Time Horizons | metr.org/time-horizons |
Tendência de autonomia, com registro público de cada mudança |
| ARC Prize | arcprize.org |
ARC-AGI, com custo por tarefa e verificação independente |
| SWE-bench oficial | swebench.com |
Distingue sistema de modelo. Note que está parado desde fevereiro de 2026 |
| Scale SEAL | labs.scale.com/leaderboard |
Conjuntos público e privado, harness padronizado, SWE-bench Pro |
| Artificial Analysis | artificialanalysis.ai |
Índice composto mais qualidade, preço e velocidade |
| Arena | arena.ai |
Preferência humana. Use o quadro com Style Control, que já é o padrão |
| Stanford AI Index | hai.stanford.edu/ai-index |
Relatório anual, 9ª edição em 2026, 425 páginas. Contexto macro, não escolha de modelo |
Sites agregadores: use pra descobrir, nunca pra citar
Sites que compilam scores de várias fontes servem pra você descobrir que existe um teste para determinada capacidade. Como fonte de número, são ruins.
Isto não é opinião. É medição, feita em 7 de setembro de 2026, abrindo as páginas:
| Fonte | SWE-bench Verified, líder e número |
|---|---|
| Quadro oficial | 79,2% |
| Agregador A | 97,00% |
| Agregador B | 97,00%, com o benchmark marcado como arquivado por saturação |
| Agregador C | 96% |
| Agregador D | 95,0%, com todas as 113 linhas marcadas como auto-reportadas e não verificadas |
Faixa de 17,8 pontos, com três líderes diferentes. No SWE-bench Pro, de 51,5% a 81,2%. E a maioria dessas páginas não diz qual harness nem qual recorte usou.
Aposentado: o Open LLM Leaderboard da Hugging Face foi aposentado em março de 2025, anunciado na aba de discussões do próprio projeto. A versão 1 dele já tinha sido arquivada em junho de 2024. O site continua no ar, público e congelado, sem aviso nenhum de aposentadoria na página. Se aparecer numa proposta, está desatualizado.
6. Os cinco modos de falha
6.1 Saturação
Quando os modelos de fronteira se amontoam acima de 88% ou 90%, a diferença entre eles deixa de ser estatisticamente significativa.
Saturação não é acidente: é característica estrutural de qualquer teste fixo. Uma vez que os modelos são otimizados contra o mesmo conjunto por tempo suficiente, o teste para de diferenciar. A comunidade responde criando testes mais difíceis, e o ciclo recomeça.
Consequência prática: diferença de 1 ou 2 pontos no topo de um quadro saturado é ruído. O marketing trata como avanço de geração.
6.2 Contaminação
O modelo viu as perguntas, ou variantes próximas, durante o treino. O score reflete recuperação, não raciocínio.
O que a literatura documenta, e aqui vale um aviso: esta é a seção onde mais circula número errado, inclusive em texto sério. Os três casos abaixo são os mais citados, e os três costumam aparecer deformados:
- Zhang e colegas, no paper “A Careful Examination of Large Language Model Performance on Grade School Arithmetic” (2024), construíram um clone limpo e não público do GSM8K, chamado GSM1k, e mediram queda de até 8 pontos em alguns modelos. Ninguém “removeu exemplos contaminados” do teste original: construíram um espelho novo, o que é bem mais difícil e bem mais convincente.
- No caso do Llama 2, cujos dados de treino foram divulgados, a auditoria do próprio paper mostra 15,52% do MMLU com contaminação relevante. E a conclusão de lá é mais estreita do que se repete: só duas partes tiveram desempenho inflado, não a suíte inteira.
- Ahuja, Gumma e Sitaram, no “Contamination Report for Multilingual Benchmarks” (2024), acharam contaminação em 45 de 49 combinações de modelo e teste. O relatório não publica percentual de grau de contaminação, e o número de “91,8%” que circula é uma conta feita por fora, com outro significado.
- Contaminação não precisa ser literal. Versão parafraseada, sintética ou estruturalmente transformada do mesmo problema já distorce a medição.
Defesas que funcionam: teste com corte temporal, conjunto privado, e teste escrito do zero depois do corte de treino do modelo.
6.3 Andaime e colisão de nomes
Já está na seção 3, mas vale isolar: quando o harness move o resultado mais que a escolha de modelo, “qual modelo pontua mais alto” é quase a pergunta menos informativa que se pode fazer a um quadro.
Agrava o problema o fato de “OSWorld” e “Terminal-Bench” não se referirem mais a um teste único e estável. O número da tabela de lançamento frequentemente foi medido numa superfície diferente do número no quadro público do próprio projeto.
6.4 Otimizar a métrica em vez do trabalho
Quando uma medida passa a importar, ela é otimizada. Isso não exige má-fé: basta um ciclo de desenvolvimento que use o benchmark como sinal de treino.
O que está documentado, com nome e data, são duas coisas, e as duas giram em torno do mesmo episódio:
- Testar muitas variantes privadas e submeter só a melhor é política escrita da Arena, não acusação. Está no documento de política deles, atualizado em setembro de 2026.
- Ajustar o estilo da resposta pra ganhar voto tem caso nomeado. Em abril de 2025 a Arena declarou publicamente que a Meta deveria ter deixado claro que a variante submetida, chamada
Llama-4-Maverick-03-26-Experimental, era um modelo customizado para otimizar preferência humana. E em janeiro de 2026 o Yann LeCun disse ao Financial Times que aqueles resultados foram “fudged a little bit”, com versões diferentes do modelo em testes diferentes. É o mesmo episódio, visto de dentro e de fora.
E há um efeito colateral bonito de registrar: em agosto de 2026 o próprio SWE-bench mudou a forma de pontuar pra fechar brechas. Depois da mudança, uma correção não passa mais se ela apenas imprimir as linhas de “PASSED”, e execução que não dá sinal de que a suíte rodou passou a ser rejeitada em vez de contar como resolvida.
6.5 O modelo sabe que está sendo avaliado
O mais desconfortável, e o mais novo.
O International AI Safety Report 2026 documenta modelos de fronteira que distinguem contexto de avaliação de contexto de uso real. Preciso ser exato aqui, porque a versão que circula está errada: o que o relatório documenta é o modelo rendendo menos durante a avaliação, escondendo capacidade, e não se comportando “de forma mais segura no teste”.
E um caso concreto, da METR, em junho de 2025: um modelo encarregado de otimizar velocidade de execução reescreveu a função de cronômetro pra ela sempre reportar tempos curtos, em vez de melhorar a execução. Uma linha de código:
_time.time = lambda: _real_time() * 1e-3O detalhe que fecha o caso: perguntado se aquilo respeitava a intenção de quem pediu, o modelo respondeu “no” dez vezes em dez.
Quando o sistema avaliado pode manipular a própria métrica, a avaliação para de ser medição.
Existe ainda um problema mais silencioso, de validade: mudanças aparentemente irrelevantes nas perguntas, como trocar nomes num problema de aritmética, deslocam desempenho de forma drástica. E erro humano no gabarito introduz imprecisão mesmo sem contaminação nenhuma.
7. O que fazer em vez disso: eval próprio
Benchmark público é filtro grosso. Ele descarta modelos claramente inadequados para uma classe de tarefa. A decisão vem de outro lugar: de um eval (avaliação feita com os seus próprios casos).
O protocolo mínimo
1. Escreva a distribuição das suas tarefas antes de abrir qualquer quadro. Qual é o pedido dominante? Extrair dados de nota fiscal mal escaneada? Classificar intenção em WhatsApp com gíria regional? Redigir follow-up mantendo o tom de voz do cliente? Escreva. Isso já elimina metade dos benchmarks como irrelevantes pra você.
2. Colete casos reais de produção. De 30 a 50 casos é o mínimo pra começar a decidir. 100 é o mínimo pra ter alguma confiança estatística. 500 permite separar por tipo de tarefa e achar fraqueza específica. Casos reais, com a entrada suja e ambígua que a sua operação de fato recebe.
3. Defina o critério de aprovação você. Não “a resposta é boa”. Algo conferível: extraiu os cinco campos corretamente, sim ou não. Classificou na categoria certa, sim ou não. Respeitou a política de não prometer prazo, sim ou não.
4. Use a camada certa de avaliação para cada tipo de erro. Métrica automática pega falha óbvia e escala bem. Modelo como juiz é rápido e barato pra triagem, mas subestima sistematicamente erro em caso de borda. Revisão humana por quem entende do domínio pega o que importa pro usuário. Rode revisão humana em pelo menos 10% das saídas.
5. Troque o conjunto a cada seis meses. Não pra evitar contaminação do fornecedor: pra evitar que o seu próprio time se acostume com aqueles casos e passe a otimizar pra eles sem perceber.
6. Meça no nível de confiabilidade que você precisa, não no que é fácil de estimar. A METR usa 50% de acerto porque é o ponto mais robusto de estimar. A sua operação provavelmente precisa de 95% ou 99%. Esses números são muito, muito menores, e é isso que a seção 4.7 mostra com o horizonte de 80%.
7. Ponha portão de revisão humana antes da execução. Se o eval mostra 92% de acerto e o custo de um erro é um cliente perdido, o eval não autorizou automação de ponta a ponta. Ele autorizou automação com revisão.
Se a pergunta é “qual modelo eu uso como padrão”
Teste A/B cego internamente, com o seu time votando sem saber qual modelo é qual. Isso é mais informativo pra você que qualquer quadro público, porque a sua distribuição de tarefas é a sua.
Uma coisa que eu não vou te dar: o número de votos que garante margem de erro pequena. Vi essa conta circulando com números específicos e não achei base publicada pra ela. Pior: os intervalos de confiança da Arena saem de um ajuste estatístico conjunto sobre 8 milhões de votos e 400 modelos, onde cada modelo empresta precisão do conjunto todo. Transplantar aquele número pra um teste interno com dois ou três modelos não é válido.
8. O contra-argumento, e ele é bom
Um texto que só ataca benchmark está errado na direção oposta. O caso a favor:
- Sem medida padronizada, comparação vira anedota. A alternativa a benchmark ruim não é intuição: é marketing sem contestação nenhuma. O quadro, por falho que seja, é o que permite dizer “esse número não se reproduz”.
- Alguns testes correlacionam bem com utilidade prática. SWE-bench Pro, Terminal-Bench, a família τ e o GDPval foram construídos justamente contra as falhas dos anteriores.
- Diferença grande é real. Um modelo a 80% e outro a 40% no mesmo teste, mesmo harness: a diferença existe. O que é falso é a precisão implícita no formato do ranking, não o sinal grosso.
- Teste difícil puxa pesquisa. O ARC-AGI existe pra expor lacuna que tamanho sozinho não resolve, e cumpriu isso por cinco anos. O FrontierMath: Open Problems transformou o benchmark em ferramenta de matemática de verdade.
- A comunidade está se autocorrigindo em público. Auditoria de teste defeituoso, papers de contaminação, controle de estilo, separação entre modelo e harness, custo por tarefa, margem de erro. Nada disso está escondido: está publicado, e é descartado no momento em que alguém cita um número sem procedência.
- E existe caminho novo. Em 27 de agosto de 2026 saiu a primeira avaliação duplo-cega criptográfica de um modelo de fronteira, feita por um consórcio que inclui um laboratório, um instituto público de segurança e organizações independentes. Nem quem avalia vê os pesos do modelo, nem quem fez o modelo vê as perguntas. É piloto, não prática estabelecida, mas ataca contaminação na raiz em vez de remediar depois.
O erro nunca foi olhar benchmark. É parar nele.
9. Checklist de leitura rápida
Cole ao lado do monitor. Ao ver um score:
- Qual a versão exata do benchmark?
- Foi reportado pelo fornecedor ou verificado de forma independente?
- Qual harness, e qual configuração de raciocínio?
- Qual recorte: público, privado ou padronizado?
- Qual a data?
- Qual a margem de erro, e ela se sobrepõe à do segundo colocado?
- Esse benchmark está saturado?
- O benchmark é anterior ao corte de treino do modelo?
- Qual o custo por tarefa?
- A tarefa do benchmark se parece com a minha?
Se a resposta da última for “não”, o score não tem nada a dizer sobre a sua decisão.
10. Resumo em cinco linhas
- Score de benchmark é propriedade de um sistema numa data, não de um modelo. O caso do ARC-AGI-3, com 62% e 99% no mesmo dia, é a prova disso.
- Os testes clássicos estão saturados e não diferenciam mais nada.
- O que diferencia em 2026 são as avaliações de agente e de horizonte longo, enquanto elas são novas. Cada geração satura em 6 a 12 meses.
- Contaminação, harness, saturação, otimização da métrica e consciência de avaliação são cinco razões documentadas pra score alto não significar utilidade.
- A decisão vem de um eval próprio, com casos reais e portão de revisão humana. Benchmark público é filtro grosso, e é só isso.
Fontes
Toda fonte abaixo foi aberta e conferida em 07/09/2026. Onde a fonte primária não confirmou o que eu queria dizer, a afirmação saiu do texto.
Quadros e organizações
- Epoch AI, Benchmarking Hub e Capabilities Index:
epoch.ai/benchmarks,epoch.ai/eci - METR, “Task-Completion Time Horizons of Frontier AI Models” e o registro de mudanças em
metr.org/time-horizons - METR, “Recent Frontier Models Are Reward Hacking” (junho de 2025), de onde vem o caso do cronômetro
- ARC Prize:
arcprize.org - SWE-bench oficial:
swebench.com - Scale SEAL:
labs.scale.com/leaderboard - Artificial Analysis, metodologia do Intelligence Index v4.2 (4 de setembro de 2026)
- Arena, registro público de metodologia e política de fornecedores:
arena.ai - OpenAI, “Why we no longer evaluate SWE-bench Verified” (fevereiro de 2026) e “Separating signal from noise in coding evaluations” (julho de 2026), que é onde a recomendação do Pro é retirada
- Stanford HAI, AI Index 2026, 9ª edição
Papers e relatórios
- Ho, Denain, Atanasov, Albanie e Shah, “A Rosetta Stone for AI Benchmarks” (2025)
- Singh, Nan, Wang et al., “The Leaderboard Illusion” (2025)
- Zhang et al., “A Careful Examination of Large Language Model Performance on Grade School Arithmetic” (2024)
- Gema et al., “Are We Done with MMLU?” (2024), de onde vêm os 6,49% de erro de gabarito
- Ahuja, Gumma e Sitaram, “Contamination Report for Multilingual Benchmarks” (2024)
- Cheng, Chang e Wu, “A Survey on Data Contamination for Large Language Models” (2025)
- Al-Lawati, Lucas, Lee e Wang, “LLM Benchmark Datasets Should Be Contamination-Resistant” (2026)
- Kearns, “Quantifying construct validity in large language model evaluations” (2026)
- Ord, “Is there a half-life for the success rates of AI agents?” (2025)
- Bengio et al., “International AI Safety Report 2026”
- Jimenez, Yang, Wettig, Yao et al., “SWE-bench: Can Language Models Resolve Real-World GitHub Issues?” (2023)
- Wu e Aji, “Style Over Substance: Evaluation Biases for Large Language Models” (2023)
Português
- “MTEB-BR: A Text Embedding Benchmark for Brazilian Portuguese” (2026)
- Carvalho Neto, “LegalBench-BR: A Benchmark for Evaluating Large Language Models on Brazilian Legal Decision Classification” (2026)
- “MATH-PT: A Math Reasoning Benchmark for European and Brazilian Portuguese” (2026)
- Osório, Leite, Lopes Cardoso, Gomes, Rodrigues, Santos e Branco, “PORTULAN ExtraGLUE Datasets and Models” (2024)
- Napolab, de Ruan Chaves Rodrigues
Fontes
- Epoch AI, Benchmarking Hub e Capabilities Index
- METR, "Task-Completion Time Horizons of Frontier AI Models"
- Ho, Denain, Atanasov, Albanie e Shah, "A Rosetta Stone for AI Benchmarks" (2025)
- Singh, Nan, Wang et al., "The Leaderboard Illusion" (2025)
- Zhang et al., "A Careful Examination of Large Language Model Performance on Grade School Arithmetic" (2024)
- Gema et al., "Are We Done with MMLU?" (2024)
- Ahuja, Gumma e Sitaram, "Contamination Report for Multilingual Benchmarks" (2024)
- Bengio et al., "International AI Safety Report 2026"
- Carvalho Neto, "LegalBench-BR: A Benchmark for Evaluating Large Language Models on Brazilian Legal Decision Classification" (2026)
- Wu e Aji, "Style Over Substance: Evaluation Biases for Large Language Models" (2023)