
Co-criador do ChatGPT lançou uma nova IA: Jev. Promete ser 200x mais rápida e 400x mais barata que os modelos atuais.
A TypeSafe lançou o Jev: um modelo que não escreve nada, só devolve números tipados com confiança. A manchete de marketing é 444 vezes mais barato. A própria empresa lista, no próprio anúncio, sete lugares onde essa conta não fecha sozinha.
No dia 15 de setembro de 2026, uma startup chamada TypeSafe AI saiu de dois anos de silêncio (o termo do setor é “stealth”, ficar escondido construindo algo antes de mostrar) e lançou um modelo de IA que se recusa a fazer a única coisa que todo mundo espera de um modelo de IA: ele não escreve texto. Nem uma frase.
O nome do modelo é Jev. Vale explicar o porquê antes do o quê: é uma homenagem a William Stanley Jevons, economista do século 19 que descreveu o seguinte paradoxo: quando uma máquina a vapor ficou mais eficiente e passou a consumir menos carvão por unidade de trabalho, o consumo total de carvão na Inglaterra aumentou, porque a eficiência liberou usos que antes eram caros demais pra valer a pena. A aposta da TypeSafe, declarada no próprio nome do produto, é a mesma lógica: cada ordem de grandeza que a inteligência artificial fica mais barata destrava ordens de grandeza a mais de uso. Não é “vamos economizar”. É “vamos multiplicar quanto isso é usado”.
O que o Jev faz de verdade
Esquece chatbot. Esquece “modelo de linguagem pequeno”. A frase que a TypeSafe usa pra descrever o próprio produto, no blog de lançamento “Introducing System One Models & Jev” (TypeSafe AI, 2026), é: “unstructured state in, typed probabilistic decisions out” (estado não estruturado entra, decisões probabilísticas tipadas saem).
Traduzindo pra prática: você não conversa com o Jev. Você manda pra ele um “estado” (pode ser uma frase solta, tipo “meu cartão foi cobrado duas vezes”, ou um bloco de dado estruturado tipo JSON) mais um conjunto de perguntas já definidas em código, com o formato da resposta esperada fixado de antemão. O Jev devolve valores dentro daquele formato, cada um com uma distribuição de probabilidade e um placar de confiança.
O exemplo que a própria documentação técnica (a referência de API, em docs.typesafe.ai) usa: você pergunta “qual time atende esse ticket de suporte”, com três opções possíveis (cobrança, técnico, vendas), e a resposta vem assim: cobrança 8%, técnico 85%, vendas 7%, com 82% de confiança. Pra uma pessoa lendo, isso é ruído. Pro código que decide pra qual fila mandar o ticket, é exatamente o que ele precisa pra decidir sozinho.
A categoria que a empresa inventou pra isso se chama “System One Model”, em referência ao livro “Rápido e Devagar: Duas Formas de Pensar” (Daniel Kahneman, 2011): o “sistema 1” é o pensamento automático, rápido, de reconhecimento de padrão, sem deliberação. A aposta de fundo é que boa parte do que hoje se pede a um modelo de linguagem generalista, como classificar, escolher entre opções ou dar uma nota, é trabalho de sistema 1, e devia custar o preço de sistema 1.
Os três jeitos de perguntar
A API do Jev (o jeito programático de conversar com ele, via POST /v1/systemone, modelo jev-latest) tem três tipos de pergunta:
- Choice (escolha): você dá um conjunto fechado de opções, e ele devolve qual delas, a probabilidade de cada uma e a confiança. É o exemplo do ticket de suporte acima.
- Score (nota): você dá níveis ordenados e descritos (0 é calmo, 1 é irritado, 2 é furioso), e ele devolve uma nota fracionária, tipo 1,4, mais a probabilidade de cada nível.
- Noul (nome próprio que a empresa deu ao terceiro tipo): pergunta de sim ou não, com a probabilidade do “sim” entre 0 e 1.
Fui testar no playground deles pra ver os três tipos de pergunta funcionando juntos. Descrevi o meu cachorro numa frase solta, sem estrutura nenhuma (“Archie é um cachorro grande com a pelagem clara e dourada, é muito amigável, ama pessoas, tem muita energia”), e fiz três perguntas de tipos diferentes sobre o mesmo texto:
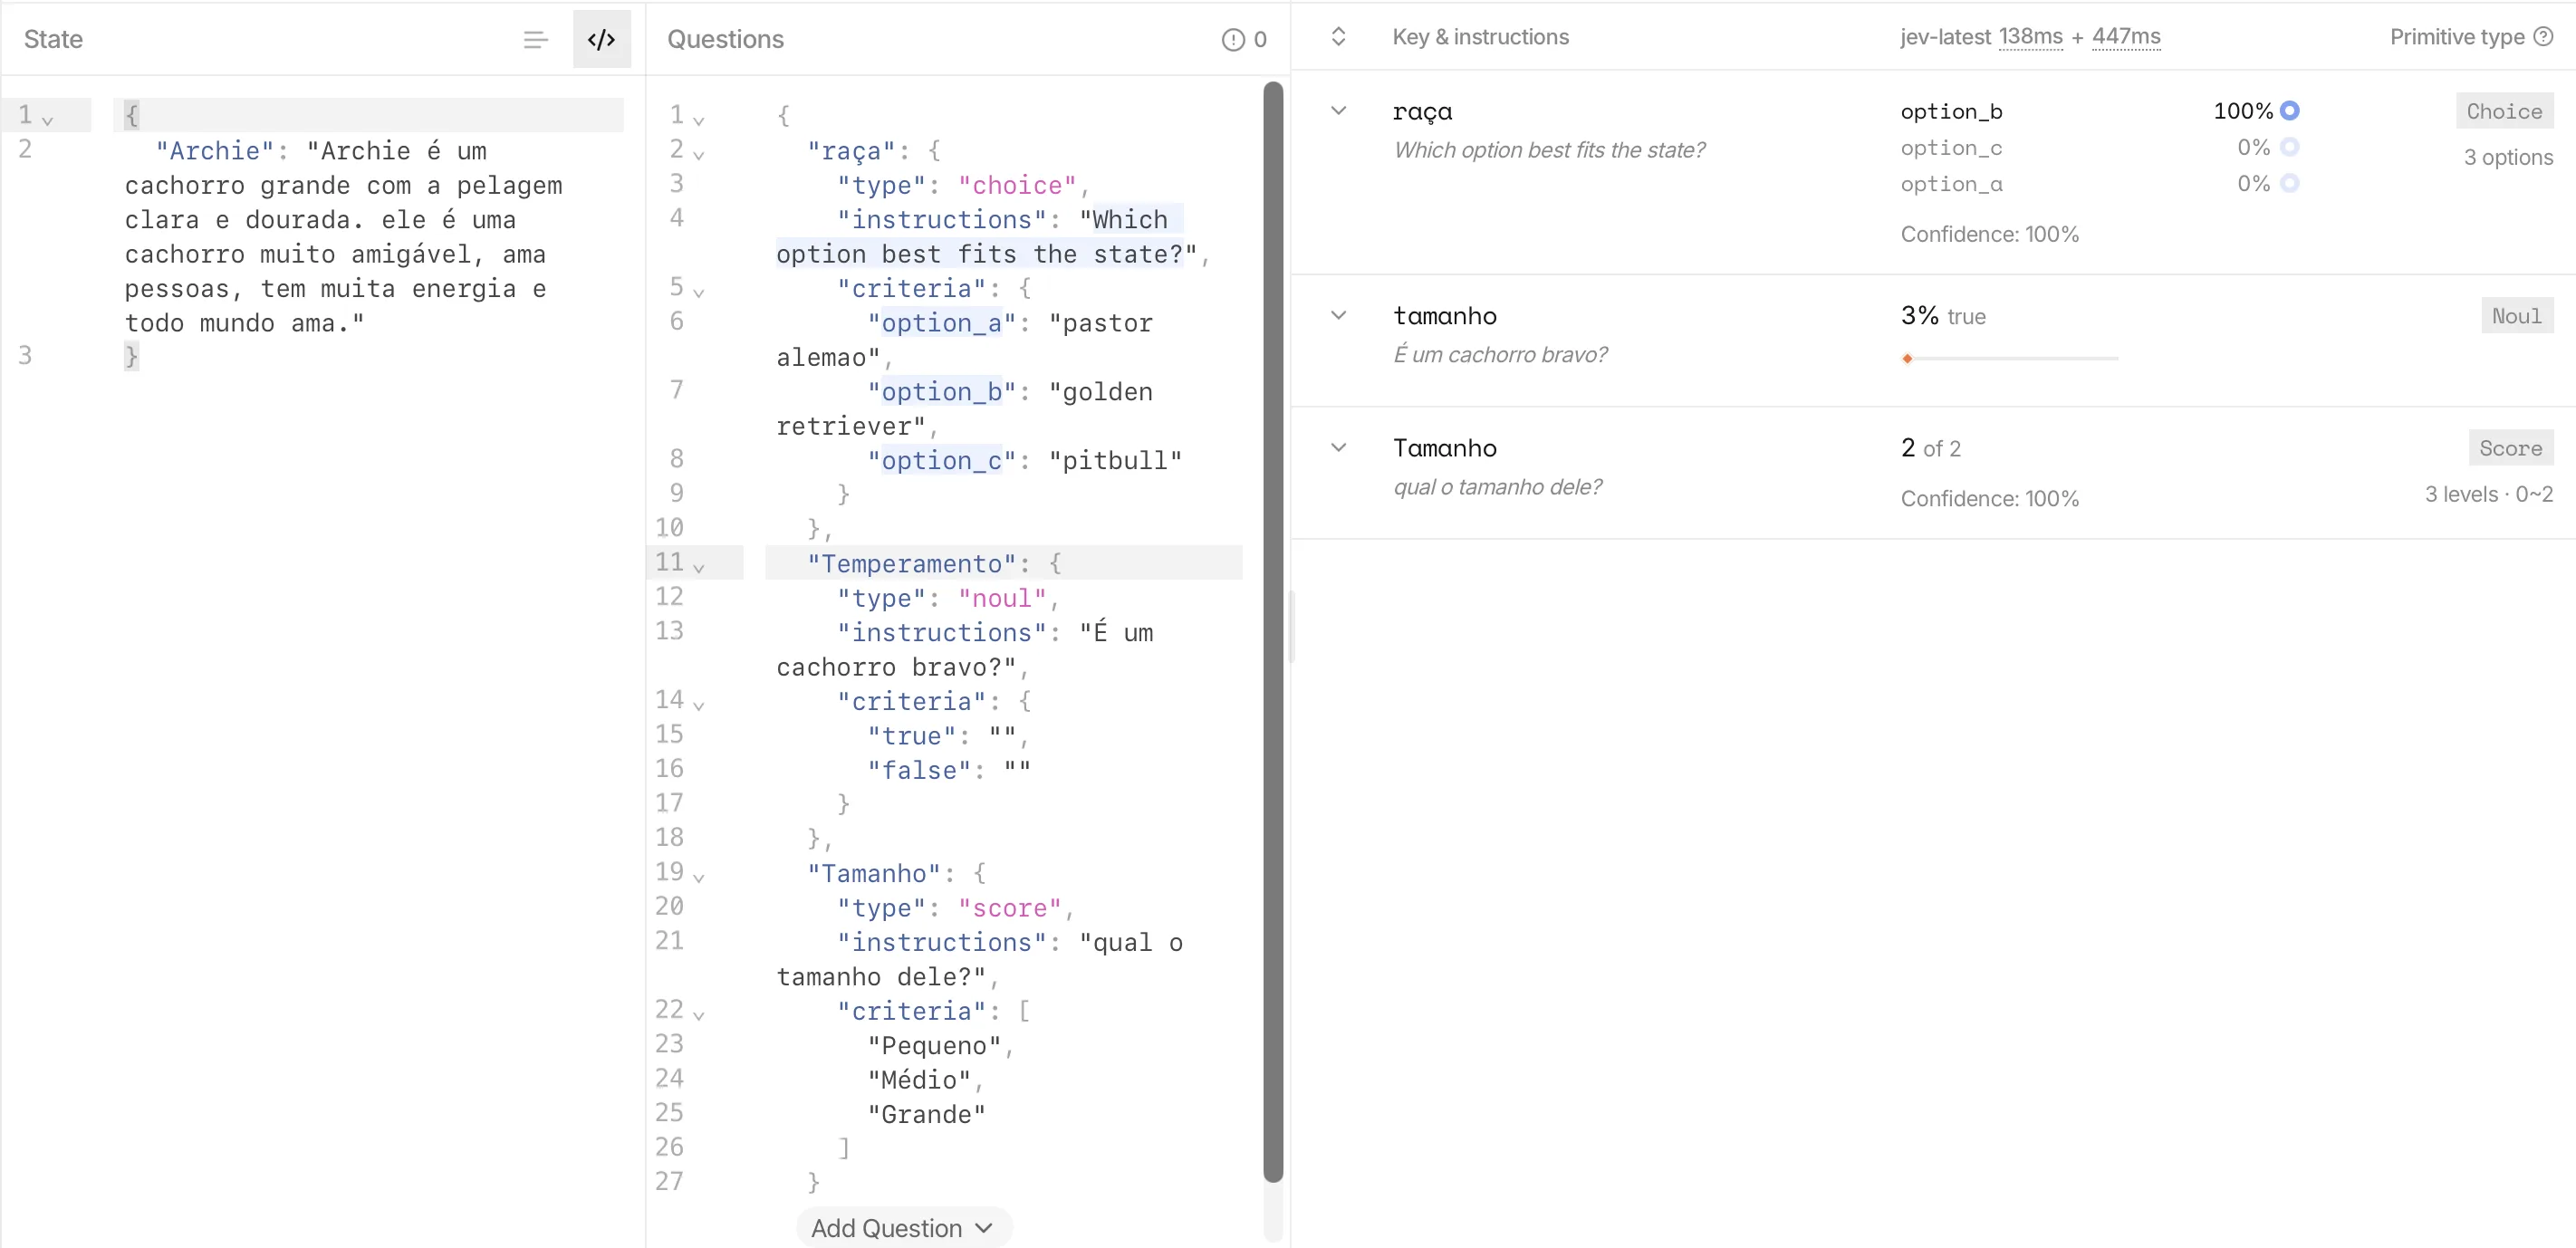
A tela é densa, então clique nela para abrir em tamanho real.
Repare no que volta do lado direito. A raça saiu como golden retriever com 100% de probabilidade e 100% de confiança, contra 0% pras outras duas opções que eu ofereci. A pergunta de sim ou não, “é um cachorro bravo?”, voltou com 3%, que é o jeito do modelo dizer “quase certamente não” sem escrever a frase. E o tamanho, numa escala de 0 a 2, voltou 2. Nenhuma linha de texto, nenhuma explicação, nenhum “claro! com base na descrição…”. Só valor e confiança, prontos pro código decidir. No meu teste a chamada levou 138 milissegundos mais 447 de processamento, o que dá a ordem de grandeza da coisa.
Tem um detalhe de desenho que explica boa parte da economia do produto: todas as perguntas de uma mesma chamada são avaliadas em paralelo, contra o mesmo estado. Adicionar mais uma pergunta praticamente não aumenta o tempo de resposta. Isso cria um padrão de uso que a documentação chama de “speculative fan-out”: em vez de pensar com cuidado quais perguntas você vai precisar, você manda todas as que talvez sirvam numa chamada só, e deixa o próprio código descartar o que não interessou daquela vez.
Confiança não é a mesma coisa que probabilidade
Um dos pontos mais bem explicados na documentação é a diferença entre as duas. A probabilidade é o valor por opção (cobrança 8%, técnico 85%). A confiança é uma estatística derivada do formato dessa distribuição inteira: se ela está concentrada numa única opção, o modelo está confiante; se está espalhada por várias, está incerto, mesmo que a opção “vencedora” tenha uma probabilidade razoável.
A documentação recomenda usar essa confiança como régua de risco, não como número único a decorar. O padrão sugerido é por faixa de risco:
- Confiança abaixo de 0,5: manda para um humano decidir, não arrisca.
- Ação reversível e leve: age direto, por exemplo mostrar um saldo.
- Ação destrutiva ou cara: só age sozinho acima de 0,9 de confiança, senão pede confirmação.
Tem uma frase da própria documentação que resume bem o motivo desse cuidado: “se um sistema inteligente, humano ou máquina, não consegue expressar incerteza honesta, o sistema não pode ser confiável.”
Por que ele é mais rápido, e de onde vem essa velocidade
Um modelo de linguagem tradicional gera texto um pedaço por vez (a unidade que ele processa se chama token, e pode ser uma palavra, parte de uma palavra ou um símbolo), e cada pedaço novo depende de todos os anteriores: é um processo em fila. O Jev não gera nada em fila. Ele avalia todas as respostas possíveis de uma vez, em paralelo, e devolve o resultado já formatado. É essa troca, abrir mão de escrever texto livre, que compra ao mesmo tempo velocidade, garantia de formato e a tal confiança calibrada.
E aqui mora o detalhe mais estranho do lançamento inteiro: quem construiu isso. O fundador e CEO da TypeSafe é Diogo Almeida, ex-OpenAI e ex-Google Brain. Ele é coautor do paper “Training Language Models to Follow Instructions with Human Feedback” (Ouyang et al., 2022, publicado no NeurIPS), o trabalho que descreveu o RLHF (aprendizado por reforço com retroalimentação humana), a técnica que transformou o GPT-3 num assistente capaz de seguir instrução e que é base direta do ChatGPT. Ou seja: o pesquisador que ajudou a inventar a técnica que fez o mundo inteiro conversar com IA está construindo uma empresa cuja aposta é que fazer a IA conversar foi, pra automação de verdade, o caminho errado.
Completam o time Sasha Sheng, ex-pesquisadora do Meta/FAIR, como COO, e Erik Gafni, fundador em série, como CTO. A empresa levantou US$ 40 milhões numa rodada seed (a primeira leva formal de investimento) liderada pelo fundo DCVC, depois de dois anos construindo em silêncio.
A tese de treino: por que não é só um RLHF menor
A empresa descreve três caminhos de pós-treino de modelo (o ajuste que vem depois do treino bruto, pra deixar o modelo útil de verdade):
- RLHF, o que o próprio Almeida ajudou a inventar: otimiza pela preferência de avaliadores humanos. Segundo a tese da TypeSafe, isso produz modelos bajuladores (que concordam demais com quem pergunta), com alucinação confiante e um efeito que eles chamam de “mode dropping”: o modelo estreita as respostas possíveis pra favorecer um estilo só, mesmo quando esse não é o mais correto.
- RLVR, que otimiza por recompensa verificável (por exemplo, uma resposta de matemática está certa ou errada): gera modelos melhores em raciocínio, mas mais lentos e mais caros.
- RLCD (“Reinforcement Learning for Calibrated Decisions”, a técnica própria da TypeSafe): o objetivo de treino não é “dar a resposta certa” nem “agradar o avaliador humano”. É fazer com que uma resposta com 80% de confiança esteja certa perto de 80% das vezes. A própria documentação é explícita sobre o limite disso: essa calibração vale sobre grupos de previsões, não como garantia individual em cada resposta isolada.
O argumento comercial por trás: um modelo que acerta 95% das vezes, mas não avisa quando está entre os 5% em que errou, não serve pra automação sem alguém olhando por cima. Um modelo que sabe dizer “não tenho certeza” nesses casos, serve.
Os números, separando medida de propaganda
Aqui está o ponto que merece mais cuidado, e onde a própria TypeSafe, para o próprio crédito, admite mais coisa do que a maioria dos lançamentos de IA costuma admitir.
O preço declarado: US$ 0,042 por milhão de tokens de entrada, e a saída sai de graça (a própria empresa usa a expressão em inglês “too cheap to meter”, barato demais pra valer a pena medir). A latência declarada pela empresa fica entre 70 e 500 milissegundos por chamada.
A manchete de marketing do site é “193,6x mais rápido, 444,6x mais barato”. Isso é uma alegação da própria fabricante, não uma medida independente, e o próprio blog de lançamento admite isso ao lado da manchete: são os ganhos do topo da faixa, não a média. Em outro trecho do mesmo blog, a faixa que a empresa dá é bem mais modesta: 40 a 200 vezes mais rápido em tarefas de “sistema 1”.
Os números mais úteis são os dos cadernos de receita técnica (cookbooks) da própria documentação, porque vêm com o experimento descrito ao lado, e dá pra ver o que foi medido. Continuam sendo experimento da fabricante, sobre dado escolhido por ela, que ninguém reproduziu:
- O caderno “Rerank with TypeSafe” reordenou os candidatos de busca de 40 perguntas jurídicas de um conjunto chamado CLERC: a chance de a resposta certa vir em primeiro lugar (top 1) subiu de 5% para 18%, e a chance de vir entre as dez primeiras (top 10) subiu de 38% para 62%.
- O caderno “Parallel questions” rodou 13 perguntas regulatórias sobre o artigo da Wikipédia sobre o GDPR (a lei europeia de proteção de dado) numa única chamada, em vez de treze chamadas separadas: 12,2 vezes mais barato e 10 vezes mais rápido, porque o texto grande do artigo (mais de 50 mil caracteres) é enviado uma vez só, em vez de treze.
- A demonstração que mais viralizou fez o Jev jogar Doom, reagindo ao estado do jogo (texto descrevendo a cena, não a imagem) cerca de dez vezes por segundo, a um custo de aproximadamente US$ 7 por hora. É um número da própria empresa, e ela mesma faz questão de dizer que um bot comum, sem IA nenhuma, jogaria melhor: o ponto da demonstração era reação em tempo real e obediência a instrução, não desempenho no jogo.
Um teste independente de verdade veio da newsletter Every, na análise “Mini-Vibe Check: TypeSafe’s Jev Judged Everything I’ve Written in 0.7 Seconds” (Mike Taylor, 2026). O autor, Mike Taylor, é head of evals (o cargo responsável por avaliação de modelo) na Every, o que dá peso técnico ao teste sem tirar dele o caráter de avaliação externa, feita por quem não trabalha pra TypeSafe. Ele usou o Jev pra apontar defeito em texto, contra o Fable 5.1 (um modelo de linguagem tradicional): o Jev respondeu em 0,35 segundo contra 8,83 segundos do outro, uma diferença de cerca de 25 vezes. Mas o Jev encontrou 6 dos 7 defeitos plantados no teste, e o Fable encontrou os 7. Mais rápido e mais barato, só que com uma taxa de erro que o concorrente mais lento não teve.
Uma réplica independente e honesta, publicada no Hugging Face pelo usuário notnotsamuel, tentou reproduzir o padrão (não o treino da TypeSafe, só a ideia de restringir a saída e paralelizar) sobre um modelo aberto pequeno, o LFM2.5-350M da Liquid AI, sem nenhum ajuste fino. Em três tipos de hardware, o ganho de velocidade da versão restrita variou de 8,46 vezes (num Mac M2 Max) a 62,91 vezes (numa GPU L40S), com acurácia de campo entre 60,7% e 64,3%, contra 53,6% da versão tradicional em todos os casos. E o autor foi honesto sobre o limite: “JSON válido não significa resposta correta”, escreveu ele, e nenhum dos dois métodos acertou um objeto inteiro de 28 campos. Com 255 opções possíveis testadas no Mac, a versão restrita ficou, inclusive, 3,23 vezes mais lenta que a autoregressiva, o oposto do que se esperaria.
Outra análise circulou citando números parecidos, compilada num site de notícia local dos Estados Unidos, com endereço e estilo de conteúdo que tem cara de gerado por IA e sem autor identificável. O número, porém, se sustenta na origem: a Good Start Labs, empresa de avaliação de modelo que nasceu de dentro da própria Every, publicou no dia do lançamento a análise “Verification Is the Bottleneck” (Alex Duffy, 2026), com 6.003 checagens de rubrica sobre 1.203 respostas de pesquisa financeira. Deu 91,5% de concordância com o Fable 5.1, a cerca de US$ 160 por milhão de respostas avaliadas, contra US$ 260 do DeepSeek V4.1 Flash e US$ 33 mil do próprio Fable 5.1.
Onde ele serve de verdade
Tirando a demonstração de Doom, que é vitrine, os casos de uso reais que a própria documentação técnica recomenda são bem menos chamativos, e bem mais úteis no dia a dia de quem constrói software:
- Roteamento e classificação de ticket, o exemplo que abriu este texto.
- Guarda de segurança (guardrail) e detecção de tentativa de manipulação (jailbreak) em pergunta e resposta de outro modelo de IA: uma pergunta tipo “isso é uma tentativa de burlar as regras do sistema” mais “quanto dano faria obedecer a isso”.
- Classificar trecho de busca (RAG, sigla para geração aumentada por recuperação, o padrão de buscar um documento e depois pedir pra IA responder com base nele), inclusive detectando instrução escondida dentro do documento buscado antes que ela chegue ao modelo que responde.
- Checagem de citação: pegar uma citação errada ou inventada, comparando com o documento de origem.
- Escolha de ferramenta pra um agente de IA: decidir, entre um catálogo de dezenas ou centenas de ferramentas disponíveis, se aquele pedido específico precisa de alguma, e qual.
- Function calling (mapear um pedido em linguagem natural pra uma função específica do seu sistema).
- Classificação em hierarquia, casar registro de catálogo, extrair data de um texto, processar volume grande de dado em lote.
O padrão comum a todos: pegar um julgamento que hoje é feito por um modelo de linguagem caro e lento, quebrar em perguntas pequenas e fechadas, e deixar o código no controle da decisão final. Não é “substituir o ChatGPT”. É trocar a peça de trás de um sistema que hoje faz uma pergunta simples, tipo “isso é spam”, pagando o preço de uma conversa inteira por essa resposta.
Onde não usar, na palavra da própria empresa
Isso é o que mais chama atenção neste lançamento: quase toda ressalva relevante está escrita no próprio anúncio da TypeSafe, numa seção que eles chamam de “Nuance” ao lado de cada alegação forte. Vale listar, porque é aqui que mora a resposta pra “quando eu não devo usar isso”:
- “Não alucina” é garantia de formato, não de verdade. O Jev não consegue devolver um valor fora do formato pedido, isso é garantido matematicamente pelo próprio desenho. Mas uma decisão perfeitamente formatada e confiantemente errada não é um erro de formato, então não aparece nesse tipo de medição. A própria empresa escreve, sobre o gráfico que mostra 0% de alucinação: “nosso número não é empírico. O casamento com o formato é garantido, então adicionamos 0% no gráfico com confiança.” As barras dos concorrentes, no mesmo gráfico, vêm de medição real; a dele vem de garantia de desenho.
- As avaliações medem concordância, não acerto. A régua de comparação usada nos testes da própria empresa é a média das respostas de dois modelos de fronteira, que eles chamam de Astra e Fable. Ou seja: a nota do Jev mede o quanto ele concorda com esses dois modelos, não o quanto ele acerta de verdade. A empresa admite as duas coisas: que isso favorece resposta parecida com o estilo da OpenAI e da Anthropic, e que os fluxos de avaliação foram montados pelo próprio time interno de capacidade do modelo, o que pode enviesar o resultado a favor da própria empresa.
- Os números de marketing não batem entre si. A manchete do site fala em 193,6x e 444,6x; o próprio blog, em outro trecho, fala em 40 a 200x; e a demonstração ao vivo, na própria página, mostra 0,114 segundo contra 8,566 segundos de um concorrente, uma diferença de cerca de 75 vezes, não 193,6. São cargas de trabalho diferentes, apresentadas lado a lado sem marcar essa diferença.
- A afirmação mais importante é a que ninguém consegue testar. A calibração, o modelo saber avisar quando não tem certeza, é o argumento central pra pagar por isso em vez de usar um modelo de linguagem qualquer com um pouco de engenharia de prompt. Não existe curva de calibração publicada, nem a métrica que o setor usa pra isso (erro de calibração esperado, ECE na sigla em inglês), nem artigo técnico revisado por pares. E o modelo está atrás de uma lista de espera.
- O preço pode estar subsidiado, e a própria empresa escreve que não tem como provar que não está: “não conseguimos provar que não é subsidiado; vamos precisar do longo prazo pra provar a sustentabilidade do nosso preço.”
- Metade da ideia técnica já existia. Restringir a saída de um modelo pra caber num formato fixo, usando gramática formal (técnica chamada GBNF), já existe desde 2023 em ferramentas abertas como o llama.cpp. Dá pra montar uma versão simples desse padrão hoje, com um modelo pequeno rodando na sua própria máquina. O que é genuinamente novo aqui é o treino de calibração (o RLCD) e o jeito de paralelizar a amostragem, não a garantia de formato em si.
- É fechado, e de um fornecedor só. Sem peso de modelo pra baixar, sem opção de rodar dentro da própria infraestrutura da empresa cliente, sem artigo reproduzível, com a API hospedada nos Estados Unidos. Do lado bom: a política de privacidade deles diz que não usa dado de cliente pra treinar nem repassa a terceiros além de prestador de serviço, o que é mais claro do que boa parte do mercado costuma ser.
O que eu tiro disso
Duas coisas ficam depois de olhar esse lançamento com calma.
A primeira é técnica, e vale além do Jev: separar “modelo de linguagem generalista” de “motor de decisão restrita” é uma distinção real, e é bem provável que apareça em mais lugares nos próximos meses. Muita coisa que hoje se resolve mandando um prompt inteiro pra um modelo caro e lendo a resposta em texto é, na prática, uma pergunta fechada, com poucas respostas possíveis. Se você constrói ou opera qualquer sistema com IA (um agente de atendimento de uma clínica pequena, um classificador de lead, uma triagem de chamado), vale perguntar: essa etapa específica precisa mesmo gerar texto livre, ou é uma escolha entre poucas opções que eu estou pagando caro demais pra fazer?
A segunda é ceticismo saudável, e essa não é sobre a TypeSafe especificamente. Este é um dos lançamentos mais honestos que já vi, no sentido de que a própria empresa lista as próprias fraquezas ao lado de cada alegação forte. Mesmo assim, a manchete que circulou o mundo foi “193,6x mais rápido, 444,6x mais barato”, não a lista de sete ressalvas. Devia ser o padrão de leitura pra todo lançamento de modelo, não só pra este: o número de marca sempre é o teto, escolhido pra impressionar. O número que serve pra decidir se você vai usar aquilo de verdade quase sempre está um parágrafo mais abaixo, na letra miúda que a própria empresa escreveu.
Fontes
- TypeSafe AI (2026). 'Introducing System One Models & Jev'. Blog oficial da TypeSafe AI. https://typesafe.ai/blog/introducing-system-one-models-and-jev
- TypeSafe AI. 'System One' (documentação técnica). https://docs.typesafe.ai/concepts/system-one
- TypeSafe AI. 'API reference' (exemplo de resposta com probabilidades e confiança). https://docs.typesafe.ai/api.md
- TypeSafe AI. 'Confidence'. https://docs.typesafe.ai/confidence.md
- TypeSafe AI. 'AI primer' (a tese de treino e o RLCD). https://docs.typesafe.ai/introduction/machine-learning-primer.md
- TypeSafe AI. 'Manifesto'. https://typesafe.ai/manifesto
- TypeSafe AI. 'Team'. https://typesafe.ai/team
- TypeSafe AI. Cookbook 'Rerank with TypeSafe' (re-ranking no conjunto CLERC). https://docs.typesafe.ai/cookbooks/rerank_typesafe.md
- TypeSafe AI. Cookbook 'Parallel questions' (briefing de GDPR em lote). https://docs.typesafe.ai/cookbooks/parallel_questions.md
- Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida et al. (2022). 'Training Language Models to Follow Instructions with Human Feedback'. NeurIPS. https://proceedings.neurips.cc/paper/2022/hash/b1efde53be364a73914f58805a001731-Abstract-Conference.html
- Mike Taylor (2026). 'Mini-Vibe Check: TypeSafe's Jev Judged Everything I've Written in 0.7 Seconds'. Every. https://every.to/also-true-for-humans/mini-vibe-check-typesafe-s-jev-judged-everything-i-ve-written-in-0-7-seconds
- Alex Duffy (2026). 'Verification Is the Bottleneck'. Good Start Labs. https://goodstartlabs.com/research/verification-is-the-bottleneck
- notnotsamuel (2026). 'LFM2.5-350M-RLCD' (cartão do modelo). Hugging Face. https://huggingface.co/notnotsamuel/LFM2.5-350M-RLCD
- Business Wire, via Morningstar (2026). 'TypeSafe AI Emerges From Stealth With $40M in Funding With New Model for Composable AI'. https://www.morningstar.com/news/business-wire/20260915525333/typesafe-ai-emerges-from-stealth-with-40m-in-funding-with-new-model-for-composable-ai